Observabilidad de procesos de trabajo en cola
La profundidad de la cola indica cuánto trabajo hay en espera. La espera en cola dice cuánto cuesta el trabajo pendiente en cada trabajo. La duración de la ejecución indica cuánto tiempo pasan los trabajadores ejecutándose. Los resultados terminales y el recuento de reintentos indican si el trabajo finalmente tiene éxito.
Necesita las cuatro señales para distinguir una ráfaga de tráfico saludable de una cola que se está quedando atrás, una dependencia lenta, una tormenta de reintentos o un trabajador que desapareció.
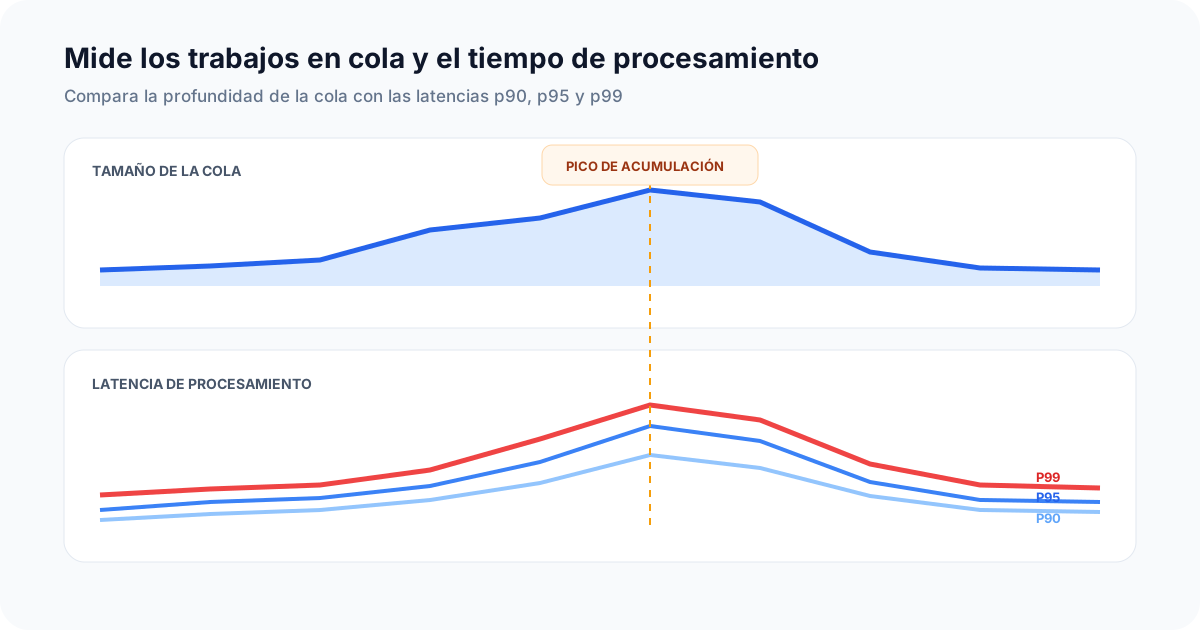
Los percentiles de cola exponen los trabajos lentos que un promedio puede eliminar.
Requisitos previos
- Una llave Telemetry API
- Un trabajador que expone los límites de los resultados de la cola, el inicio y la terminal
- Identificadores de trabajo lógicos estables y nombres de trabajo de baja cardinalidad
- Una ventana de finalización esperada para cada tipo de trabajo crítico
Instantáneas del modelo y resultados por separado
Utilice dos formas de eventos porque responden a preguntas diferentes:
| Evento | grano | uso |
|---|---|---|
queue_snapshot |
Una cola a la vez | Profundidad actual, trabajadores disponibles, edad de espera más avanzada |
background_job_completed |
Un resultado terminal por trabajo lógico | Espera, duración de la ejecución, reintentos, éxito, fallo permanente |
Una instantánea es un estado de muestra, por lo que no sume la profundidad de su cola a lo largo del tiempo. Un resultado terminal es un trabajo completado, por lo que no puede encontrar un trabajo que comenzó y desapareció. Agregue eventos de ciclo de vida ligeros job_started y job_finished cuando se requiera la detección de trabajos estancados.
Definir el contrato de evento terminal
Utilice el esquema de trabajo en segundo plano completado como punto de partida:
| campo | Significado |
|---|---|
event_id |
Evento de terminal único utilizado para la deduplicación |
job_id |
Identificador de trabajo lógico estable compartido entre intentos |
job_name |
Tipo de trabajo limitado, nunca una carga útil dinámica o ID |
queue_name |
Cola que ejecutó el trabajo. |
account_id |
Cuenta seudónima afectada por el resultado |
attempt_count |
Intentos totales, incluido el intento terminal |
queue_wait_ms |
Poner en cola para la primera ejecución |
duration_ms |
Duración de la ejecución del intento de terminal |
status |
success o permanente error |
release |
Versión de trabajador o aplicación |
Mantenga los argumentos del trabajo, las credenciales, las direcciones de correo electrónico, el contenido de los documentos y el texto de excepción sin formato fuera del evento. Utilice un error_type limitado si los operadores necesitan categorías de falla.
Instrumentar el límite de resultados
Instale e inicialice el JavaScript SDK:
npm install telemetry-sh
import telemetry from "telemetry-sh";

telemetry.init("YOUR_API_KEY");
Mida la puesta en cola, el primer inicio y la finalización del terminal con el mismo reloj. Emitir una fila terminal después del éxito o reintentar el agotamiento:
async function processJob(job) {
  const startedAtMs = Date.now();
  let terminalAttemptStartedAtMs = startedAtMs;
  let attemptCount = 0;

  try {
    const result = await runWithRetry(async () => {
      attemptCount += 1;
      terminalAttemptStartedAtMs = Date.now();
      return performJob(job);
    });

    await telemetry.log("background_job_completed", {
      event_id: crypto.randomUUID(),
      job_id: job.id,
      job_name: job.name,
      queue_name: job.queue,
      account_id: job.accountId,
      attempt_count: attemptCount,
      queue_wait_ms: startedAtMs - job.enqueuedAtMs,
      duration_ms: Date.now() - terminalAttemptStartedAtMs,
      total_elapsed_ms: Date.now() - startedAtMs,
      status: "success",
      release: process.env.APP_RELEASE ?? "unknown"
    });

    return result;
  } catch (error) {
    await telemetry.log("background_job_completed", {
      event_id: crypto.randomUUID(),
      job_id: job.id,
      job_name: job.name,
      queue_name: job.queue,
      account_id: job.accountId,
      attempt_count: attemptCount,
      queue_wait_ms: startedAtMs - job.enqueuedAtMs,
      duration_ms: Date.now() - terminalAttemptStartedAtMs,
      total_elapsed_ms: Date.now() - startedAtMs,
      status: "error",
      error_type: classifyJobError(error),
      release: process.env.APP_RELEASE ?? "unknown"
    });

    throw error;
  }
}
Este ejemplo mantiene el intento de terminal en duration_ms y el tiempo completo del muro de la política de reintento en total_elapsed_ms. Si su biblioteca de reintentos informa estos límites de manera diferente, adapte los temporizadores conservando los dos significados documentados.
La llamada de telemetría debe seguir el cambio de estado duradero del trabajo. Decida cómo su aplicación maneja las fallas en la entrega de telemetría sin convertir un trabajo que ya fue exitoso en un reintento de su efecto secundario comercial. Conserve event_id en un reintento de entrega de telemetría cuando se reenvía el mismo evento de terminal.
Estado de la cola de muestra
Recopile instantáneas en un intervalo fijo del estado autorizado de la cola:
async function recordQueueSnapshot(queue) {
  const state = await queue.inspect();

  await telemetry.log("queue_snapshot", {
    event_id: crypto.randomUUID(),
    queue_name: queue.name,
    depth: state.waitingCount,
    active_workers: state.activeWorkers,
    oldest_wait_ms: state.oldestEnqueuedAtMs
      ? Date.now() - state.oldestEnqueuedAtMs
      : 0,
    release: process.env.APP_RELEASE ?? "unknown"
  });
}
Mantenga el intervalo lo suficientemente frecuente como para detectar un retraso significativo, pero no tan frecuente como para que muestras idénticas dominen el volumen de eventos. Registre la profundidad cero como cero; no lo omitas.
Separe la espera de cola del tiempo de ejecución
Esta consulta compara la espera típica y de cola con la duración de ejecución de cola:
SELECT
  job_name,
  COUNT(*) AS jobs,
  approx_percentile_cont(queue_wait_ms, 0.50) AS p50_wait_ms,
  approx_percentile_cont(queue_wait_ms, 0.95) AS p95_wait_ms,
  approx_percentile_cont(duration_ms, 0.95) AS p95_run_ms
FROM background_job_completed
WHERE timestamp_utc >= now() - INTERVAL '24 hours'
GROUP BY job_name
HAVING COUNT(*) >= 20
ORDER BY p95_wait_ms DESC;
Una espera alta de p95 con un tiempo de ejecución normal apunta hacia la capacidad, la programación, la priorización o el manejo de ráfagas. Tiempo de ejecución elevado con puntos de espera normales hacia el código de trabajo o una dependencia. El aumento conjunto de ambos puede significar que la lentitud del trabajo está consumiendo la capacidad de los trabajadores y creando un retraso.
Medir reintentos y fallos de terminal
Debido a que el evento del terminal registra un trabajo lógico, attempt_count > 1 significa que el trabajo se recuperó después de al menos un reintento:
SELECT
  job_name,
  COUNT(*) AS jobs,
  SUM(CASE WHEN attempt_count > 1 THEN 1 ELSE 0 END) AS retried_jobs,
  SUM(CASE WHEN status = 'error' THEN 1 ELSE 0 END) AS permanent_failures,
  100.0 * SUM(CASE WHEN attempt_count > 1 THEN 1 ELSE 0 END)
    / NULLIF(COUNT(*), 0) AS retried_job_rate_pct,
  100.0 * SUM(CASE WHEN status = 'error' THEN 1 ELSE 0 END)
    / NULLIF(COUNT(*), 0) AS permanent_failure_rate_pct
FROM background_job_completed
WHERE timestamp_utc >= now() - INTERVAL '7 days'
GROUP BY job_name
ORDER BY permanent_failure_rate_pct DESC, retried_job_rate_pct DESC;
Si emite una fila por intento, utilice un campo attempt y un job_id estable; el denominador y la interpretación serán diferentes. Documente el detalle de la fila al lado de cada consulta para que los reintentos no se cuenten accidentalmente como trabajos de cliente separados.
Detectar trabajo estancado y perdido
Una tabla exclusiva de terminal no puede distinguir un trabajo de larga duración de uno perdido después de un accidente laboral. Emita job_started más job_completed o job_failed con el mismo job_id, luego use una unión izquierda para buscar inicios sin un evento de terminal.
El umbral debe ser específico del trabajo o derivarse de una ventana de finalización esperada. Los trabajos de larga duración pueden necesitar eventos de latidos. Agregue un breve período de gracia para el retraso en la entrega de eventos para que las filas más nuevas no generen falsos positivos.
Utilice el consulta de trabajos en segundo plano estancada completo en lugar de tratar la profundidad de la cola como prueba de que un trabajo en particular está estancado.
Contabilización de mensajes fallidos, prioridades y cierres
Registre una categoría o evento de terminal distinto cuando se agote la política de reintentos y un trabajo ingrese a una cola de mensajes fallidos. Seguimiento de la repetición como una nueva acción operativa vinculada al job_id original; no reescribas silenciosamente el fracaso original.
Segmente las señales de capacidad por cola o prioridad cuando los trabajadores no sean intercambiables. Una cola masiva en buen estado puede ocultar una cola crítica bloqueada en un promedio general.
Durante implementaciones y cierres:
- dejar de aceptar nuevos trabajos antes de despedir a los trabajadores;
- permitir un intervalo de drenaje documentado;
- distinguir una cola intencional de una falla de ejecución;
- preservar el
job_idlógico y el estado de intento de incremento; - verificar que cada trabajo iniciado eventualmente produzca un evento terminal.
Construye el tablero
El Ejemplo de panel de trabajos en segundo plano proporciona el SQL, resultado sintético e interpretación. Un panel de producción debe incluir:
- profundidad de la cola actual y edad de espera más antigua por cola;
- cola de espera p50 y p95 por nombre de trabajo;
- p95 duración de la ejecución por nombre del trabajo;
- tasas de reintentos laborales y fracasos permanentes;
- trabajos estancados actuales con identificadores de correlación seguros;
- volumen por versión para que se pueda comparar una implementación con el cambio.
Utilice períodos de tiempo completos para las tendencias. Establezca reglas de volumen mínimo antes de clasificar las tarifas. Un único trabajo fallido en una cola silenciosa es importante desde el punto de vista operativo sólo cuando ese flujo de trabajo es crítico; de lo contrario, no debería superar una regresión de alto volumen sólo por porcentaje.
Alerta sobre una respuesta, no solo un umbral
Vincula cada alerta a un propietario y acción:
| Condición | pregunta probable | Primera respuesta |
|---|---|---|
| Aumento de profundidad y espera más antigua | ¿La demanda supera la capacidad? | Consulta tasa de llegada, trabajadores, prioridad y salud de dependencia. |
| El tiempo de ejecución aumenta mientras la espera es estable | ¿Se ralentizó el código de trabajo o una dependencia? | Comparar categoría de versión y error |
| La tasa de reintentos aumenta | ¿La falla transitoria está amplificando el trabajo? | Inspeccionar los tipos de errores acotados y el estado del proveedor |
| Aumentan las fallas permanentes | ¿Está agotada la recuperación? | Identificar cuentas afectadas y estado de letra muerta |
| El inicio no tiene ningún evento terminal | ¿Se produjo un accidente laboral o desapareció la instrumentación? | Inspeccionar el trabajador, los latidos del corazón y el estado del trabajo. |
Evite paginar en un depósito incompleto. Exija una infracción sostenida o una falla terminal crítica y mantenga el umbral alineado con el tiempo de finalización esperado del flujo de trabajo.
Validar antes de la producción.
Ejecute un dispositivo para:
- éxito del primer intento;
- reintento seguido de éxito;
- falla permanente y entrada de mensajes no entregados;
- entrega de eventos duplicados;
- accidente laboral tras
job_started; - trabajo de larga duración con un latido del corazón;
- una cola explosiva que se drena normalmente;
- un cierre de implementación y una puesta en cola.
Confirme el recuento de trabajos lógicos, el recuento de intentos, la cola de espera, la duración de la ejecución, los eventos de terminal faltantes y el recuento de cuentas afectadas. Verifique también que la falla de telemetría no pueda reproducir una operación comercial no idempotente.
Próximos pasos
Continúe con receta de espera en cola, receta de tasa de reintento de trabajo en segundo plano, receta de trabajos en segundo plano estancado y caso de uso de supervisión de trabajos en segundo plano.