Seguimiento de costes de la API de OpenAI por modelo y función
Para realizar un seguimiento de los costos de OpenAI API, registre el uso del token, el modelo, la latencia, los reintentos y un costo estimado de la solicitud junto con la característica del producto y el cliente que provocó la llamada. Esto convierte una factura de proveedor inexplicable en un gasto que puede consultar por modelo, función, equipo y resultado.
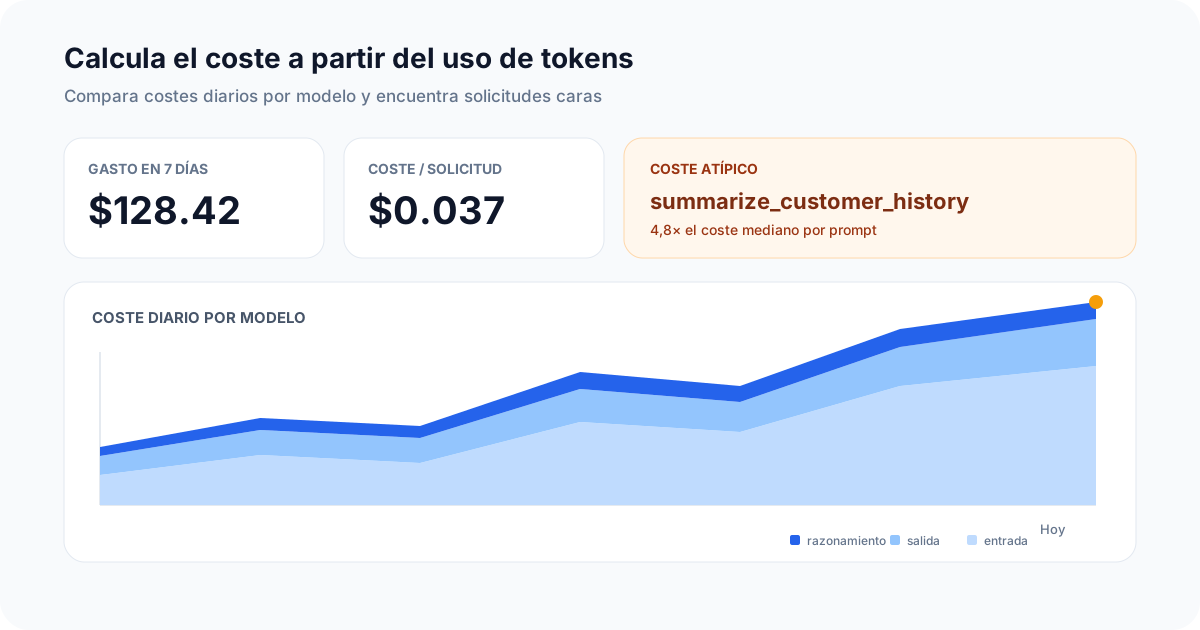
La telemetría a nivel de solicitud conecta la tendencia de costos con el modelo y la carga de trabajo que la causó.
El evento más útil combina el uso del proveedor con el contexto del producto. El recuento de tokens explica el consumo; campos como feature, team_id, status y accepted explican si la solicitud produjo valor.
Vea un panel de costos del OpenAI en menos de un minuto
Comience con un evento de muestra gratuito sobre el uso del OpenAI. El inicio rápido crea un evento claramente marcado, abre una consulta de costos lista para ejecutar y mantiene el resultado en su panel de introducción. Puede inspeccionar el flujo de trabajo antes de cambiar el código de la aplicación.
La muestra generada utiliza la forma de costo mínimo útil:
{
  "provider": "openai",
  "model": "gpt-5",
  "input_tokens": 1250,
  "output_tokens": 340,
  "cost_usd": 0.0184,
  "latency_ms": 842,
  "status": "ok",
  "sample": true
}
Ejecute esto inmediatamente contra la tabla telemetry_quickstart generada:
SELECT
  model,
  COUNT(*) AS requests,
  SUM(input_tokens) AS input_tokens,
  SUM(output_tokens) AS output_tokens,
  ROUND(SUM(cost_usd), 4) AS total_cost_usd,
  ROUND(AVG(latency_ms), 0) AS average_latency_ms
FROM telemetry_quickstart
WHERE provider = 'openai'
GROUP BY model
ORDER BY total_cost_usd DESC;
Requisitos previos
- Una llave Telemetry API
- Una llave OpenAI API
- Node.js y el OpenAI JavaScript SDK oficial
1. Instale e inicialice los SDK
npm install openai telemetry-sh
import OpenAI from "openai";
import telemetry from "telemetry-sh";

const openai = new OpenAI();
telemetry.init(process.env.TELEMETRY_API_KEY);
Mantenga ambas claves API en las variables de entorno del lado del servidor. No los ponga en el control de código fuente ni en el código del navegador.
2. Mantener los precios fuera de la instrumentación
El precio del OpenAI y la disponibilidad del modelo pueden cambiar. Lea las tarifas actuales del página oficial de precios de OpenAI y almacene las tarifas que utiliza en la configuración.
Este ejemplo utiliza USD por millón de tokens:
OPENAI_MODEL="YOUR_MODEL"
OPENAI_INPUT_USD_PER_MILLION="YOUR_CURRENT_INPUT_RATE"
OPENAI_CACHED_INPUT_USD_PER_MILLION="YOUR_CURRENT_CACHED_INPUT_RATE"
OPENAI_CACHE_WRITE_USD_PER_MILLION="YOUR_CURRENT_CACHE_WRITE_RATE"
OPENAI_OUTPUT_USD_PER_MILLION="YOUR_CURRENT_OUTPUT_RATE"
OPENAI_PRICING_VERSION="provider-price-sheet-reviewed-YYYY-MM-DD"
const pricing = {
  inputUsdPerMillion: Number(process.env.OPENAI_INPUT_USD_PER_MILLION),
  cachedInputUsdPerMillion: Number(
    process.env.OPENAI_CACHED_INPUT_USD_PER_MILLION
  ),
  cacheWriteUsdPerMillion: Number(
    process.env.OPENAI_CACHE_WRITE_USD_PER_MILLION
  ),
  outputUsdPerMillion: Number(process.env.OPENAI_OUTPUT_USD_PER_MILLION),
};

function estimateCostUsd({
  inputTokens,
  cachedInputTokens,
  cacheWriteTokens,
  outputTokens,
}) {
  const uncachedInputTokens = Math.max(
    0,
    inputTokens - cachedInputTokens - cacheWriteTokens
  );

  return (
    (uncachedInputTokens * pricing.inputUsdPerMillion +
      cachedInputTokens * pricing.cachedInputUsdPerMillion +
      cacheWriteTokens * pricing.cacheWriteUsdPerMillion +
      outputTokens * pricing.outputUsdPerMillion) /
    1_000_000
  );
}
Utilice la factura de su proveedor como fuente veraz de facturación. La entrada en caché, los tokens de razonamiento, el procesamiento por lotes, las herramientas, las imágenes, el audio u otras características del modelo pueden requerir campos y reglas de precios adicionales.
No sustituya silenciosamente la velocidad de entrada estándar cuando se realiza una lectura en caché o Se desconoce la tasa de escritura de caché. Marque el presupuesto como incompleto hasta el momento actual. Se ha revisado la hoja de precios del proveedor. Configuración de precios clave por proveedor, modelo, nivel de servicio y tiempo efectivo en lugar de sobrescribirlos en su lugar.
3. Instrumentar una solicitud de Respuestas API
El actual OpenAI JavaScript SDK expone las respuestas API a client.responses.create. Una respuesta completa incluye un objeto usage con input_tokens, output_tokens y total_tokens.
async function createDraftReply({ input, teamId, userId, attempt = 1 }) {
  const model = process.env.OPENAI_MODEL;
  const startedAt = Date.now();

  try {
    const response = await openai.responses.create({
      model,
      input,
    });

    const inputTokens = response.usage?.input_tokens ?? 0;
    const outputTokens = response.usage?.output_tokens ?? 0;
    const cachedInputTokens =
      response.usage?.input_tokens_details?.cached_tokens ?? 0;
    const cacheWriteTokens =
      response.usage?.input_tokens_details?.cache_write_tokens ?? 0;
    const reasoningTokens =
      response.usage?.output_tokens_details?.reasoning_tokens ?? 0;
    const estimatedCostUsd = estimateCostUsd({
      inputTokens,
      cachedInputTokens,
      cacheWriteTokens,
      outputTokens,
    });

    await telemetry.log("llm_request_completed", {
      response_id: response.id,
      provider: "openai",
      model: response.model ?? model,
      feature: "draft_reply",
      team_id: teamId,
      user_id: userId,
      status: "success",
      attempt,
      input_tokens: inputTokens,
      cached_input_tokens: cachedInputTokens,
      cache_write_tokens: cacheWriteTokens,
      output_tokens: outputTokens,
      reasoning_tokens: reasoningTokens,
      total_tokens: response.usage?.total_tokens ?? inputTokens + outputTokens,
      estimated_cost_usd: estimatedCostUsd,
      latency_ms: Date.now() - startedAt,
      service_tier: response.service_tier ?? "not_reported",
      pricing_version: process.env.OPENAI_PRICING_VERSION,
    });

    return response.output_text;
  } catch (error) {
    await telemetry.log("llm_request_failed", {
      provider: "openai",
      model,
      feature: "draft_reply",
      team_id: teamId,
      user_id: userId,
      status: "error",
      attempt,
      error_type: error?.constructor?.name ?? "unknown_error",
      latency_ms: Date.now() - startedAt,
    });

    throw error;
  }
}
De forma predeterminada, no registre solicitudes sin procesar, finalizaciones, argumentos de herramientas, credenciales o contenido privado del cliente. Prefiera categorías seguras como feature, workflow, input_category, output_category y error_type.
La guía actual de almacenamiento en caché de mensajes de OpenAI documenta cached_tokens en
usage.input_tokens_details para respuestas Resultados y documentos de API
cache_write_tokens para familias de modelos que informan escrituras en caché. También muestra
reasoning_tokens en detalles del token de salida. Consulte el almacenamiento en caché rápido
requisitos oficial.
Los tokens de razonamiento se detallan dentro de la contabilidad del token de salida de la respuesta; hacer
No los agregue a output_tokens por segunda vez al estimar el total de un token.
Mantenga el campo separado porque puede explicar un cambio en el costo, la latencia o
comportamiento.
4. Incluya los reintentos en el costo
Un reintento a nivel de aplicación es una nueva solicitud facturable incluso cuando el usuario ve
una acción de producto. Llevar un operation_id estable entre intentos e incrementos
attempt. Registre el resultado de la aplicación del terminal por separado.
await telemetry.log("ai_operation_completed", {
  operation_id: operationId,
  response_id: response.id,
  team_id: teamId,
  feature: "draft_reply",
  attempts: attempt,
  outcome: "accepted",
  accepted: true,
});
Esto admite el costo por operación lógica, el costo por salida aceptada y el reintento.
amplificación. No deduplicar eventos de costo de solicitud simplemente porque comparten
una operation_id; cada solicitud de proveedor puede contribuir al costo.
5. Conecte el gasto con un resultado
El costo por solicitud no indica si el resultado fue útil. Registre un evento de resultado independiente cuando el usuario acepte, copie, guarde, regenere o descarte el resultado.
await telemetry.log("ai_output_reviewed", {
  response_id: responseId,
  team_id: teamId,
  user_id: userId,
  feature: "draft_reply",
  outcome: "accepted",
  accepted: true,
});
Un response_id estable le permite unir el uso y los resultados sin almacenar el resultado del modelo.
6. Consultar costo diario por característica y modelo.
Telemetry agrega automáticamente timestamp_utc, por lo que la aplicación no necesita enviar su propio campo de marca de tiempo.
SELECT
  date_trunc('day', timestamp_utc) AS day,
  feature,
  model,
  COUNT(*) AS requests,
  SUM(input_tokens) AS input_tokens,
  SUM(cached_input_tokens) AS cached_input_tokens,
  SUM(cache_write_tokens) AS cache_write_tokens,
  SUM(output_tokens) AS output_tokens,
  SUM(reasoning_tokens) AS reasoning_tokens,
  ROUND(SUM(estimated_cost_usd), 4) AS estimated_cost_usd,
  ROUND(AVG(latency_ms), 0) AS avg_latency_ms
FROM llm_request_completed
WHERE timestamp_utc >= now() - INTERVAL '30 days'
GROUP BY day, feature, model
ORDER BY day ASC, estimated_cost_usd DESC;
Visualice estimated_cost_usd como un gráfico de áreas o líneas apiladas dividido por feature o model. Combínelo con el volumen de solicitudes y la tasa de producción aceptada para que un aumento de costos pueda interpretarse en contexto.
7. Conciliar estimaciones con la factura.
Solicite respuestas de telemetría de dónde provino el gasto. La factura del proveedor responde. lo que se facturó. Conciliar ambos en un grano compartido como proyecto de proveedor, modelo, nivel de servicio, moneda y día de facturación UTC.
SELECT
  date_trunc('day', timestamp_utc) AS day,
  model,
  service_tier,
  pricing_version,
  COUNT(*) AS requests,
  ROUND(SUM(estimated_cost_usd), 4) AS estimated_cost_usd
FROM llm_request_completed
WHERE timestamp_utc >= now() - INTERVAL '30 days'
GROUP BY
  date_trunc('day', timestamp_utc),
  model,
  service_tier,
  pricing_version
ORDER BY day ASC, model ASC, service_tier ASC;
Almacene el total de la factura en un conjunto de datos independiente controlado por finanzas y luego compare períodos comparables. Las diferencias pueden provenir de cambios de precios, incompletos. eventos, créditos, procesamiento por lotes o prioritario, herramientas sin token, imágenes, audio, conversión de moneda o un proyecto de proveedor que falta en la telemetría de la aplicación. No “arregle” el historial de eventos simplemente para forzar un acuerdo; registrar la conciliación explicación.
Sobre qué alertar
Las alertas útiles incluyen:
- gasto diario estimado por encima del presupuesto esperado;
- costo por producto aceptado por encima de un umbral probado;
- los reintentos o fallas aumentan para un modelo o característica;
- el recurso compartido de entrada en caché cae después de un cambio de esquema de herramienta o aviso;
- las escrituras en caché aumentan sin el correspondiente beneficio futuro de lectura de caché;
- el intercambio de tokens de razonamiento cambia para una versión rápida o flujo de trabajo;
- la latencia de p95 aumenta mientras que la tasa de salida aceptada se mantiene estable o disminuye;
- eventos de uso que llegan sin un
pricing_versionreconocido.
Próximos pasos
Utilice el Costo de LLM por característica receta SQL completo para inspeccionar un resultado de ejemplo y el diseño del panel. Luego agregue el receta aceptada de producción de IA por dólar para comparar el valor del producto con el gasto estimado.
Para obtener una ruta de implementación completa, continúe con Integración de agentes OpenAI, Plantilla de seguimiento de costos de LLM y Guía de productos de telemetría de agentes de IA. Estas páginas conectan datos de costos a nivel de solicitud con ejecuciones de agentes, llamadas de herramientas, paneles y resultados de productos retenidos.
Para conocer la forma subyacente API, consulte Inicio rápido para desarrolladores OpenAI y Respuestas Referencia API.