Arquitectura de Telemetry
Telemetry valida el JSON entrante, guarda los eventos aceptados en un búfer y los almacena como archivos Parquet en S3. Las consultas SQL combinan el búfer con los datos almacenados, así que puedes consultar eventos recientes antes de la siguiente carga.
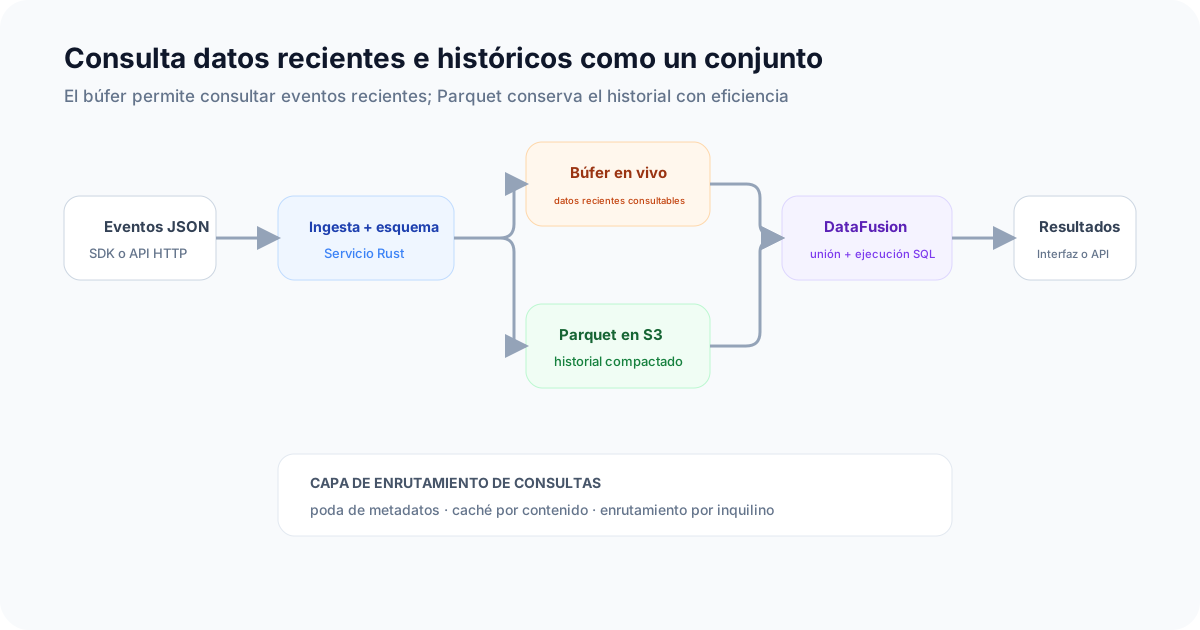
Las consultas combinan el búfer activo con los archivos Parquet almacenados.
Ingesta de datos y búfer
Un servicio Rust compara cada evento JSON entrante con el esquema de su tabla. Añade los eventos compatibles a un búfer. El búfer se carga en S3 al alcanzar 15 minutos o 10.000 filas.
Consultas en tiempo real
Las consultas leen tanto los eventos del búfer como los datos almacenados en S3 o en la caché de disco. Los eventos no tienen que esperar al vaciado del búfer para aparecer en los resultados.
Evolución del esquema
Telemetry añade campos nuevos al esquema de la tabla a medida que llegan eventos. Las filas existentes no tienen valor para esos campos. Añadir un campo y cambiar su tipo son operaciones distintas. Consulta evolución del esquema para ver reglas y ejemplos de migración.
Tolerancia a fallos y gestión del búfer
El servicio vacía su búfer durante un cierre ordenado. Una cola de mensajes fallidos conserva los datos que no se pudieron procesar o vaciar para recuperarlos. Estas vías de recuperación no evitan pérdidas en todos los fallos. Las aplicaciones deben definir sus reintentos y verificar la entrega de los eventos que no pueden perder.
Compactación
La compactación combina archivos Parquet pequeños en otros mayores. Esto reduce el número de archivos que debe abrir una consulta y permite comprimir más filas juntas.
Selección de archivos para una consulta
Telemetry analiza SQL como un árbol de sintaxis abstracta para identificar tablas, intervalos de tiempo y filtros. Usa los metadatos de los archivos para elegir los que necesita la consulta y recuperarlos de S3.
Caché de disco y enrutamiento de consultas
Telemetry guarda archivos en disco según su contenido y dirige las consultas de cada cliente a un servidor que probablemente los tenga. Un acierto de caché evita una descarga de S3. La latencia depende de los datos leídos, la consulta y la presencia de los archivos necesarios en caché.
Ejecución de consultas
Apache DataFusion ejecuta SQL sobre los archivos seleccionados y devuelve los resultados. Consulta la referencia SQL de DataFusion para conocer los patrones admitidos.